‘아이스버그’라는 말을 들으면 빙산이 떠오르지 않나요? 타이타닉호를 침몰시킨 그런 빙산? 데이터 책인데 왜 갑자기 아이스버그일까요? 혹시 데이터 엔지니어들이 데이터의 바다를 항해하다가 아이스버그와 충돌하는 걸까요?
실제로 원고에 ‘데이터 레이크’도 나옵니다. 데이터의 바다…가 아니라 호수(lake)인가 봐요. 하지만 정작 배는 나오지 않았습니다. 대신 테이블, 파케이, 메타데이터, 매니페스트, 스냅샷, 카탈로그 같은 단어들이 줄줄이 등장했습니다. 이쯤 되니 빙산보다 제가 먼저 가라앉을 것 같았습니다.
아파치 아이스버그란 ‘오픈 테이블 형식’이라고 합니다. 데이터를 호수 같은 곳에 저장하는 것까지는 알겠는데, 그 위에 왜 또 ‘테이블 형식’이라는 게 필요한 걸까요? 엑셀도 표고 데이터베이스도 표인데, 데이터 파일을 모아놓고 테이블이라고 부르면 안 되는 걸까요?
데이터 레이크는 저렴하고 유연하게 대량의 데이터를 저장하기에는 아주 좋다고 합니다. 하지만 데이터가 많아지고 여러 사용자가 동시에 읽고 쓰기 시작하면 문제가 복잡해지죠. 어떤 파일이 현재 테이블에 속하는지, 업데이트 도중 문제가 생기면 어디까지 되돌려야 하는지, 컬럼이나 파티션 구조가 바뀌면 기존 데이터는 어떻게 처리할지, 수천 수만 개의 파일 중에서 쿼리에 필요한 것은 무엇인지 등을 관리할 필요가 생깁니다.
이런 문제를 해결하기 위해 등장한 게 바로 아파치 아이스버그라고 합니다. 실제 데이터는 파케이 같은 파일에 그대로 두면서, 그 위에 메타데이터와 스냅샷 등의 계층을 만들어 데이터를 하나의 일관된 ‘테이블’처럼 다룰 수 있게 합니다. 덕분에 트랜잭션, 시간 여행, 스키마 진화, 파티션 진화 등 널리 쓰이는 데이터베이스 기능을 데이터 레이크에서도 활용할 수 있다고 합니다. 또한 스파크, 플링크, 드레미오 같은 서로 다른 엔진이 같은 테이블을 함께 사용할 수 있다는 점도 유용합니다.
국내 최초로 아이스버그를 소개하는 책이다 보니 원고가 많이 낯설었습니다. copy-on-write와 merge-on-read 같은 부분을 읽으며 제가 지금 데이터를 읽는 것인지 데이터가 저를 읽는 것인지 헷갈리는 순간도 있었습니다. 스냅샷에 브랜치와 태그까지 등장하자 “내가 지금 Git 책을 편집하고 있었나?” 싶기도 했습니다.
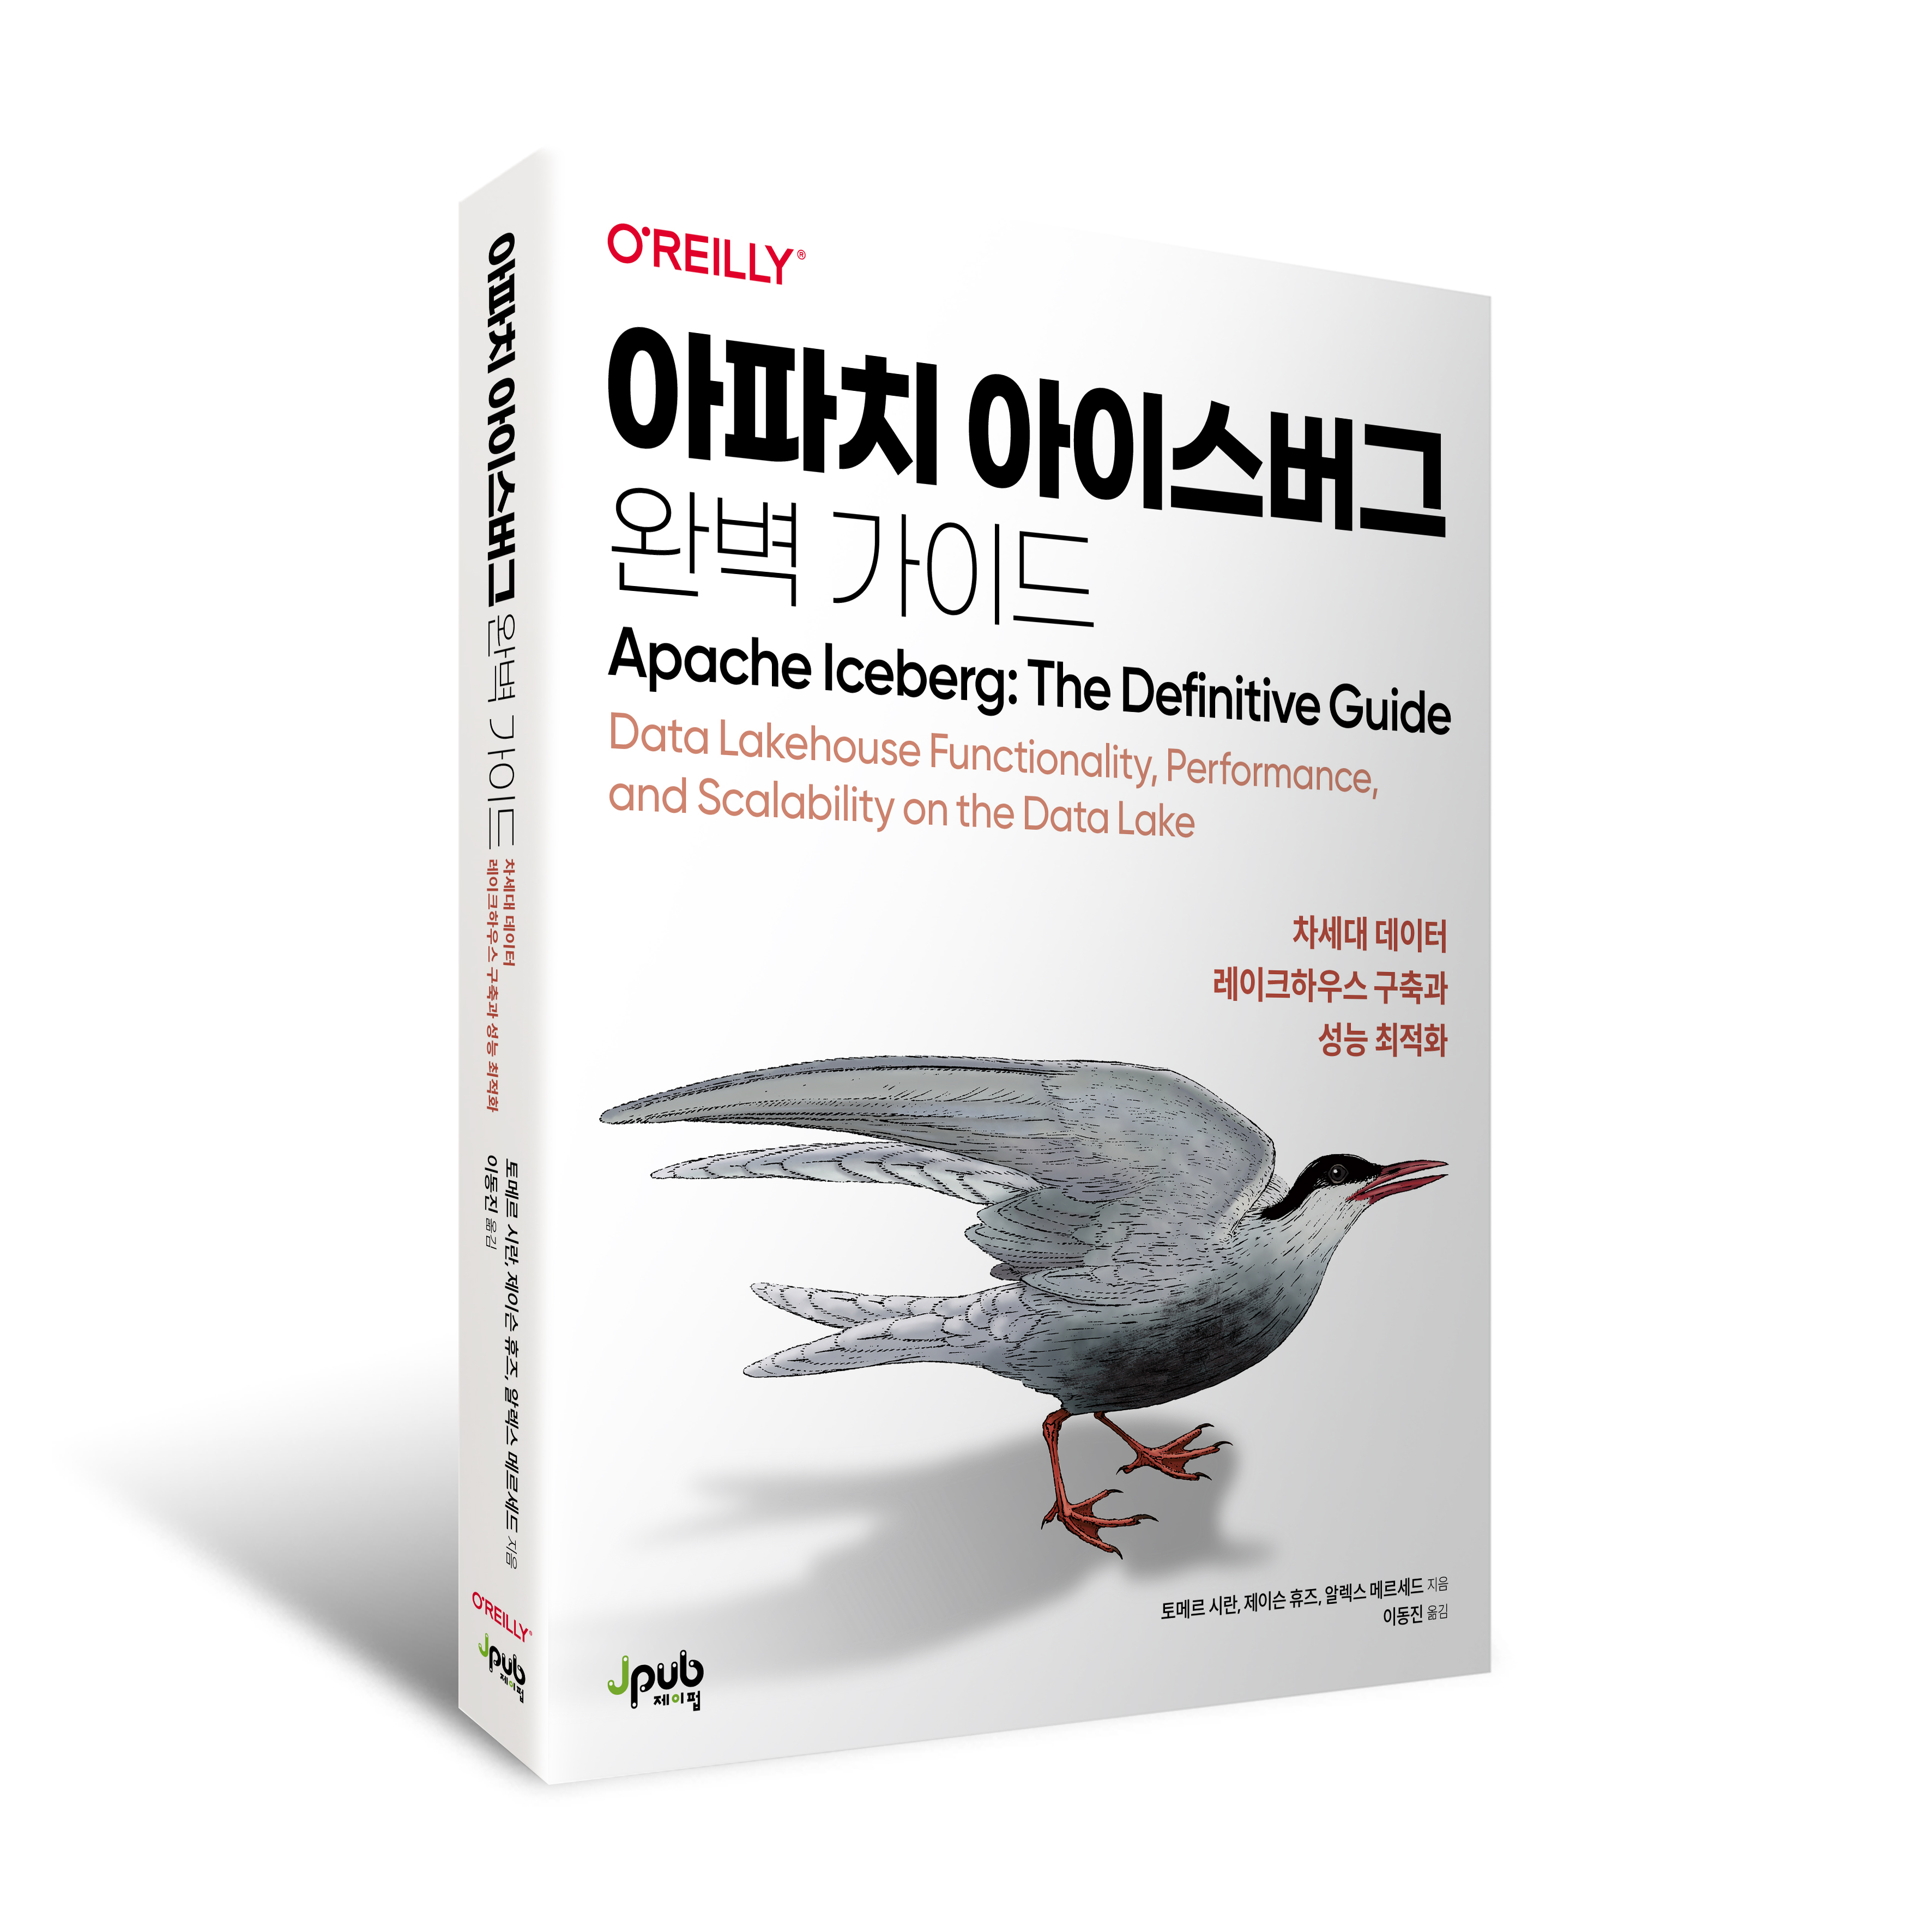
반대로 말하면, 개념들이 하나씩 연결되는 재미가 있는 책이기도 합니다. 명령어 모음집이 아니라 데이터 레이크 위에 제대로 된 데이터 플랫폼을 만드는 방법을 설명하는 책이니까요. 어떤 기능이 있다는 사실만 알려주는 데서 그치지 않고, 왜 그런 기능이 필요한지, 내부에서는 실제로 어떤 일이 벌어지는지까지 차근차근 따라갑니다. 데이터 엔지니어에게 실질적인 도움을 될 책이라고 생각합니다.
덧: 사실 최근 뉴스에 아이스버그가 자주 등장하기도 했습니다. 아이스버그 레티스(iceberg lettuce)라는 양상추의 한 종류가 있다고 하네요. 물론 이 책에는 먹을 수 있는 것은 나오지 않습니다.
■ 미리보기(앞부속, 본문 일부)
■ 도서구매 사이트(가나다순)
| [교보문고] [도서11번가] [알라딘] [예스이십사] [쿠팡] |
■ 제이펍 소식 더 보기(제이펍의 소통 채널에서 더욱 다양한 소식을 확인하세요!)
| 블로그 유튜브 인스타그램 트위터 페이스북 |
'출간 전 책 소식' 카테고리의 다른 글
| 제이펍, 게임 책에 진심인 편 (0) | 2026.09.30 |
|---|---|
| 그림을 좋아하는 것과 그림으로 먹고사는 것은 다르니까요 (0) | 2026.09.11 |
| 넓은 마당이 없어도, 완벽하지 않아도 괜찮아요. (0) | 2026.09.10 |
| “이런 것도 직접 만들 수 있을까?” (0) | 2026.09.03 |
| 고민하지 말고, 그냥 Postgres를 쓰세요! (0) | 2026.09.02 |


